Sammanfattning: Robots.txt är en textfil i sitens rotkatalog som talar om för sökmotorer och andra bots vilka delar av siten de får crawla. En enda felaktig rad kan blockera hela siten från Google, vilket gör filen till en vanlig orsak bakom plötsliga rankingtapp. Artikeln förklarar syntaxen rad för rad, går igenom de fem vanligaste felen, visar konfigurationer för WordPress, stagingmiljöer och AI-bots samt hur du verifierar att filen fungerar.
Skriven: 13 november 2026, Petter Cete, Performance Marketing Specialist
Det är en av de minsta filerna på hela siten, ofta bara några rader lång. Ändå kan den fälla allt ni byggt upp i Google. Men låt dig inte luras av storleken. Det är den här filen som bestämmer vilka delar av siten Google får besöka, och det räcker med ett litet skrivfel för att sidor ska börja tappa i rankingen.
I denna artikel går vi igenom hur filen fungerar, hur du skriver den rätt och hur du undviker vanliga fallgropar.
Vad robots.txt gör och varför fel kostar synlighet
Robots.txt är en textfil som ligger i sitens rotkatalog, alltså direkt efter domännamnet på dindomän.se/robots.txt, och ger instruktioner till bots, exempelvis Googlebot, om vilka sidor och mappar de får besöka. När en bot kommer till din site kollar den först robots.txt, och följer sedan de regler som står där.
Med andra ord har några få rader text stor makt över hur er site syns i Google, på gott och ont. Ett felaktigt Disallow-direktiv kan stänga ute Google från hela siten, och då slutar nya sidor att indexeras och befintliga sidor tappar i synlighet.
En viktig sak att ha koll på är skillnaden mellan att blockera crawling och att blockera indexering. Robots.txt hindrar bots från att besöka en sida. Noindex-taggen tillåter att sidan besöks, men talar om att den inte ska visas i sökresultaten. Det låter som en detalj, men det har stor betydelse. En sida som är blockerad i robots.txt kan fortfarande dyka upp i Google om andra sidor länkar till den, eftersom Google aldrig får läsa sidan och därmed aldrig ser någon noindex-tagg.
Men robots.txt är heller inget säkerhetsverktyg. Filen är offentlig och bots som inte vill följa den gör det inte. Känsligt innehåll ska skyddas med inloggning.
Korrekt syntax och vanliga direktiv
Robots.txt byggs upp av grupper. Varje grupp börjar med en eller flera User-agent-rader som anger vilken bot reglerna gäller, följt av de regler som ska gälla för just den boten.
Så här kan en grundläggande fil se ut:
# Regler för alla bots
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /sok?

# Regler enbart för Googlebot
User-agent: Googlebot
Disallow: /intern/

Sitemap: https://dindomän.se/sitemap.xml
User-agent anger vilken bot regeln gäller. En asterisk betyder alla bots, medan exempelvis Googlebot eller Bingbot pekar ut en specifik.
Disallow anger en sökväg som boten inte får crawla. Disallow: /wp-admin/ blockerar allt i den mappen. Ett tomt Disallow betyder att allt är tillåtet.
Allow öppnar upp en specifik sökväg inom en blockerad mapp. Om två regler matchar samma URL följer Google den mest specifika, alltså den med längst sökväg.
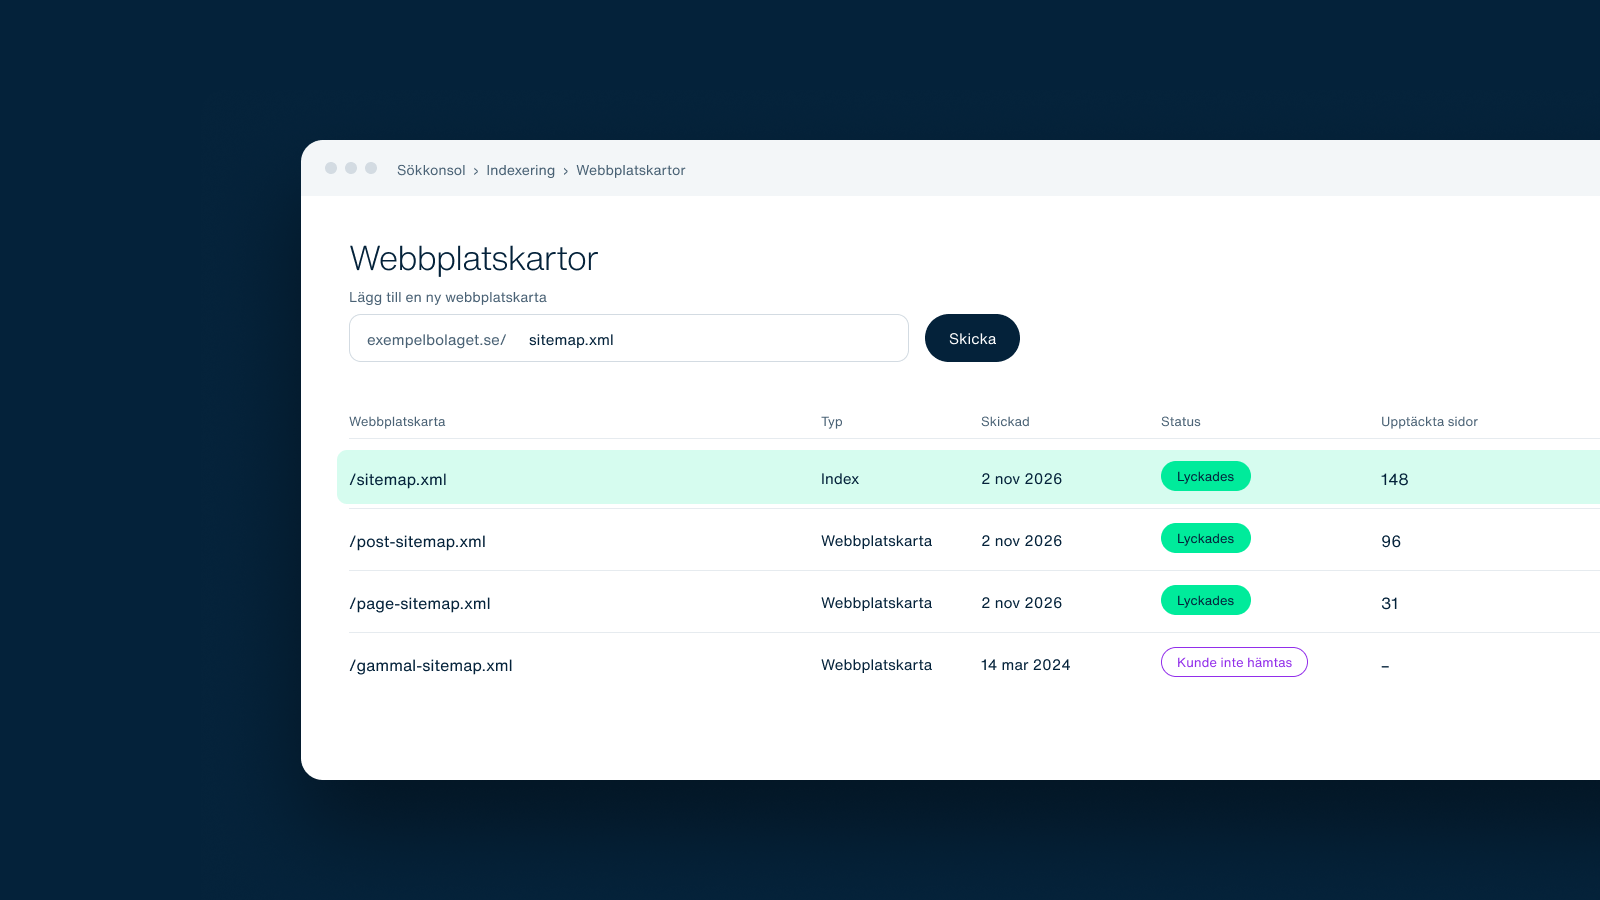
Sitemap talar om var din sitemap finns. Raden kan stå var som helst i filen och gäller oberoende av grupperna.
Crawl-delay anger hur många sekunder en bot ska vänta mellan anropen. Bing följer direktivet, men Google ignorerar det helt.
Google stödjer också två specialtecken. Asterisk matchar valfri teckenföljd, så Disallow: /*?filter= blockerar alla URL:er med den parametern. Dollartecken markerar slutet på en URL, så Disallow: /*.pdf$ blockerar alla PDF-filer. Tänk också på att sökvägarna är skiftlägeskänsliga, så /Tjanster/ och /tjanster/ räknas som två olika sökvägar.
De fem vanligaste robots.txt-felen
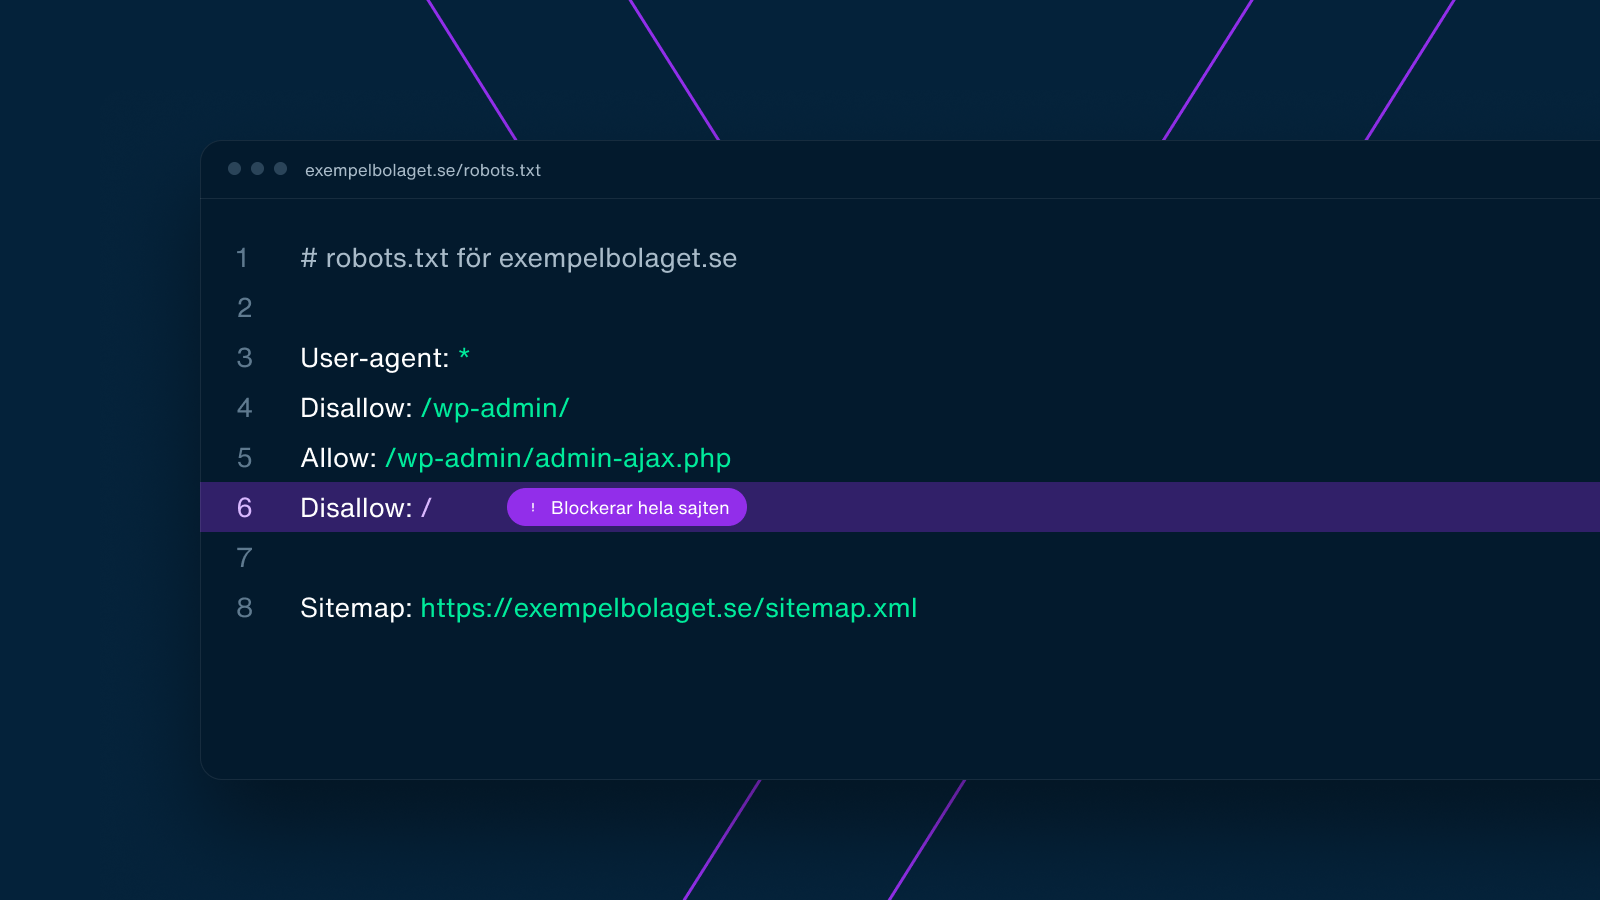
1. Disallow: / som blockerar hela siten
Detta är ett klassiskt misstag som vi ser väldigt ofta. Ett enda snedstreck efter Disallow stänger ute bots från allt. Det händer oftast när en site flyttas från staging till produktion och stagingmiljöns robots.txt följer med. Se därför till att alltid kontrollera filen direkt efter en lansering.
2. Blockerade CSS- och JavaScript-filer
Google renderar sidor ungefär som en webbläsare och behöver tillgång till CSS och JavaScript för att förstå hur sidan ser ut och fungerar. Blockerar du mappar med de filerna ser Google bara en avskalad version av sidan, utan design och layout, och innehåll som laddas in via JavaScript kan saknas helt. Det kan få Google att bedöma sidan som mindre användarvänlig, vilket påverkar rankingen.
3. Krockande grupper för olika user-agents
Det här felet är lurigt, eftersom det ser helt rätt ut. Varje bot läser nämligen bara en grupp i robots.txt. Finns det en grupp som är riktad till just den boten väljer den den gruppen, och struntar helt i gruppen som gäller alla bots.
Ta det här exemplet:
User-agent: *
Disallow: /admin/

User-agent: Googlebot
Disallow: /intern/
Det är lätt att tro att Googlebot ska undvika både /admin/ och /intern/. Men eftersom det finns en grupp med Googlebots namn läser den bara den, och blockerar därför enbart /intern/. Mappen /admin/ är alltså fritt fram för Google. Vill du att en regel ska gälla för Googlebot också behöver du skriva in den i Googlebots egen grupp.
4. Bortglömt sitemap-direktiv
Detta är ingen katastrof, men en missad möjlighet. Sitemap-raden gör att alla sökmotorer hittar din sitemap, även de du inte skickat in den till manuellt. Det betyder att exempelvis Bing och andra sökmotorer också får en tydlig karta över siten, vilket gör att nya och uppdaterade sidor hittas snabbare.
5. Filen ligger på fel ställe
Robots.txt måste ligga i rotkatalogen, på dindomän.se/robots.txt. En fil i en undermapp ignoreras helt. Varje subdomän behöver dessutom en egen fil, så blogg.dindomän.se och dindomän.se har var sin robots.txt.
Specifika konfigurationer för olika behov
- WordPress: Att blockera /wp-admin/ är helt okej, men lägg till ett Allow för /wp-admin/admin-ajax.php eftersom många teman och plugins använder den filen. Kontrollera också att /wp-content/uploads/ inte är blockerad, annars kan Google inte indexera era bilder.
- Stagingmiljöer: En stagingmiljö ska inte synas i Google. Blockera den helt med Disallow: /, men skydda den helst också med lösenord eftersom alla bots inte följer robots.txt. Och se till att stagingens robots.txt aldrig följer med till den skarpa siten.
- Stora siter: Använd Crawl-delay sparsamt. Det påverkar inte Google, och för de bots som följer direktivet kan ett för högt värde göra att nya sidor upptäcks långsammare. Fokusera hellre på att blockera parametriserade URL:er och interna sökresultat som slösar crawlbudget.
- AI-bots: Allt fler AI-tjänster crawlar webben, och de flesta stora uppger att de respekterar robots.txt. Vill du blockera dem behöver du ange deras specifika user-agents, till exempel GPTBot för OpenAI eller ClaudeBot för Anthropic. Tänk dock igenom beslutet. Blockerar du AI-bots minskar chansen att ert innehåll syns och citeras i AI-svar, och vill du istället hjälpa AI-tjänsterna att förstå siten är llms.txt ett bra komplement.
Hur du verifierar att robots.txt fungerar
Besök filen direkt. Gå till dindomän.se/robots.txt i webbläsaren och kontrollera att filen visas och innehåller det du förväntar dig.
Kontrollera statuskoden. Med kommandot curl -I https://dindomän.se/robots.txt i terminalen ser du att filen svarar med HTTP 200.
Använd robots.txt-rapporten i Search Console. Under Inställningar hittar du rapporten som visar vilken version av filen Google har hämtat, när det skedde och om den innehåller fel eller varningar.
Testa enskilda sidor. Med verktyget för URL-inspektion i Search Console ser du om en specifik sida blockeras av robots.txt.
Håll koll på indexeringsrapporten. Dyker statusen "Blockerad av robots.txt" upp för sidor som borde synas i Google är det dags att se över filen.
Vanliga frågor om robots.txt
Måste jag ha en robots.txt-fil?
Tekniskt nej, men i praktiken ja. Utan robots.txt får bots fritt fram till alla sidor. Även en minimal fil med bara ett sitemap-direktiv är bättre än ingen alls, och det tar bara några minuter att skapa en grundläggande version.
Vad är skillnaden mellan robots.txt och noindex?
Robots.txt hindrar bots från att crawla en sida. Noindex tillåter crawling men förhindrar att sidan visas i sökresultaten. Vill du att en sida ska försvinna från Google ska du använda noindex och se till att sidan inte är blockerad i robots.txt, eftersom Google annars aldrig ser noindex-taggen.
Var ska robots.txt-filen ligga?
I rotkatalogen, alltså på dindomän.se/robots.txt. Bots letar bara där, och en fil i en undermapp ignoreras. Subdomäner behöver en egen fil, så blogg.dindomän.se/robots.txt och dindomän.se/robots.txt är helt oberoende av varandra.
Kan jag blockera AI-bots med robots.txt?
Ja, för de bots som följer robots.txt, vilket de stora AI-bolagen uppger att de gör. Skriv User-agent: GPTBot följt av Disallow: / för att blockera OpenAIs crawler, och motsvarande för exempelvis ClaudeBot. Tänk på att innehåll som redan crawlats inte försvinner, och att en blockering minskar chansen att synas i AI-svar.
Vad händer om robots.txt har syntaxfel?
Google hoppar över rader som den inte förstår och följer resten. Det gör konsekvenserna svåra att förutse, eftersom vissa regler gäller och andra inte. Granska därför alltid filen och kontrollera robots.txt-rapporten i Search Console efter varje ändring.
Få en site audit av er site
Har ni tappat i ranking utan att förstå varför, eller vill ni vara säkra på att ingenting i den tekniska grunden håller tillbaka er synlighet? I vår site audit går vi igenom allt från robots.txt och indexering till Core Web Vitals, innehåll och länkstruktur, och ger er en tydlig plan för vad som behöver åtgärdas.